Jev, l’IA de TypeSafe : automatiser des décisions sans perdre la main
Jev, l’IA de TypeSafe, répond par des probabilités, pas par du texte. Démos à l’appui : comment l’utiliser pour trier vos demandes en gardant la main.
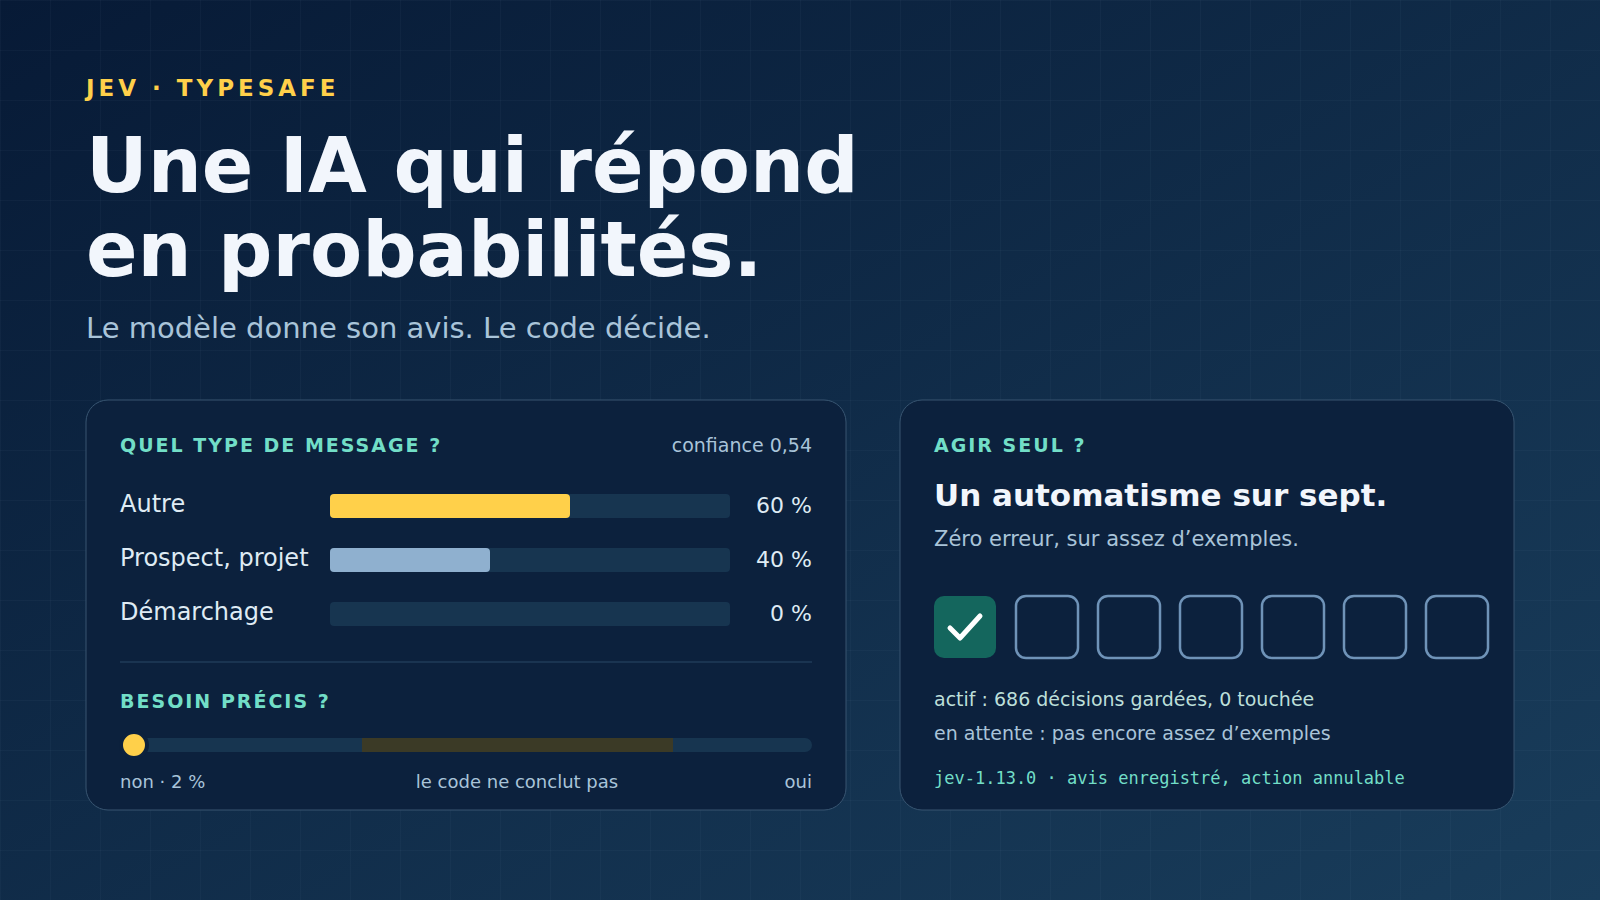
Trier les demandes qui arrivent par votre formulaire de contact, écarter les démarchages, vérifier qu’une offre fournisseur correspond bien à un produit : ces décisions répétitives sont de bonnes candidates à l’automatisation par l’IA. Encore faut-il pouvoir faire confiance à ce que l’IA décide.
Jev, le modèle d’intelligence artificielle de la société TypeSafe, aborde la question autrement que ChatGPT : il ne rédige rien, il répond par un choix et des probabilités que votre code peut vérifier. Chez Webdesign29, nous l’avons intégré en septembre 2026 à cinq outils que nous développons et exploitons pour nos clients. Voici comment il fonctionne, ce qu’il fait déjà pour nous, et pourquoi nous ne le laissons agir seul que lorsque les chiffres le permettent.
Qu’est-ce que Jev, l’IA de TypeSafe ?
Jev est un modèle d’intelligence artificielle qui répond à des questions fermées par des probabilités. Conçu par la société TypeSafe, c’est le premier modèle de ce qu’elle appelle la famille « System One », en référence au « système 1 » décrit par le psychologue Daniel Kahneman : le jugement rapide et intuitif, par opposition au raisonnement lent et délibéré.
Concrètement, on lui envoie deux choses. D’abord un état : le texte à juger et le contexte utile, par exemple le message reçu et la liste des services de l’entreprise. Ensuite des questions dont on a défini à l’avance les réponses possibles. Toutes les questions partent dans le même appel et sont évaluées en parallèle, chacune sans voir les autres. Le résultat est une réponse structurée qu’un programme lit directement.
TypeSafe explique entraîner Jev pour des décisions calibrées : sur un grand nombre de réponses, une probabilité de 0,8 doit se vérifier environ huit fois sur dix. C’est une propriété d’ensemble, pas une garantie pour chaque réponse. C’est pourquoi nous mesurons toujours le modèle sur des décisions réelles avant de lui confier quoi que ce soit.
Jev ou ChatGPT : quelle différence avec un LLM ?
Comme un grand modèle de langage (LLM) de type ChatGPT ou Claude, Jev comprend le texte. La différence tient à ce qu’il renvoie. Un LLM produit des phrases, qu’il faut ensuite relire ou analyser pour en tirer une décision. Jev ne produit ni phrase, ni explication, ni code : seulement la réponse à la question posée, dans le format prévu.
| LLM (ChatGPT, Claude…) | Jev (TypeSafe) | |
|---|---|---|
| Ce qu’il renvoie | Du texte rédigé. | Un choix, une probabilité ou une note. |
| Usage type | Rédiger, résumer, raisonner, converser. | Trier, orienter, vérifier, classer. |
| Ce que le programme en fait | L’analyser pour en tirer une décision. | Le lire directement et appliquer une règle. |
| Son erreur typique | Un fait inventé dans un texte plausible. | La mauvaise option, que la distribution signale souvent par une hésitation. |
Les deux se complètent. Pour rédiger la réponse à un client, un LLM reste l’outil adapté. Pour décider si ce message mérite une réponse, et qui doit s’en charger, un modèle comme Jev est plus simple à interroger et à contrôler.
TypeSafe détaille aussi ses limites : Jev ne lit que du texte, reste plus précis en anglais qu’en français, compte mal, compare mal les dates et lit les consignes au pied de la lettre. Chez nous, le calcul reste donc dans le code, et les questions sont rédigées en anglais avec un glossaire du vocabulaire métier de nos clients. Côté coût, TypeSafe facture 0,042 $ par million de jetons envoyés : un message de la démonstration ci-dessous revient à un peu plus d’un centième de centime.
Choix, oui ou non, note : trois façons de poser une question
Jev ne connaît que trois types de questions. Ce vocabulaire réduit est justement ce qui rend ses réponses faciles à combiner dans un programme.
| Type | Ce qu’il renvoie | Un exemple chez nous |
|---|---|---|
| Choix | Une option parmi une liste que vous définissez, la probabilité de chacune et une confiance. | « Ce message est-il une demande de projet, un client existant, un démarchage, une candidature… ? » |
| Oui ou non (« noul » chez TypeSafe) | La probabilité que l’énoncé soit vrai, de 0 à 1. | « Le message nomme-t-il un besoin précis ? » |
| Note (« score ») | Une position sur des niveaux décrits en toutes lettres, avec la probabilité de chaque niveau. | « Faut-il traiter cette demande ? », de 0 (pas pour nous) à 3 (besoin clairement exprimé). |
Pour un choix ou une note, TypeSafe calcule une confiance à partir de la forme des probabilités : concentrées sur une option, elle est haute ; étalées entre plusieurs, elle est basse. Elle mesure la netteté de la réponse, pas sa justesse. Une question oui ou non, elle, n’a pas de confiance : sa valeur est déjà une probabilité. À 0,5, elle veut dire « le modèle ne sait pas », pas « plutôt oui ». Notre code réserve donc à cette zone du milieu un traitement à part : ni oui, ni non, une personne tranche.
Démo interactive : qualifier des demandes de contact avec l’IA
La qualification des leads, c’est-à-dire le tri des demandes entrantes selon leur intérêt (on parle aussi de lead scoring), est un bon terrain d’essai. Voici sept messages inventés, du type de ceux que reçoit le formulaire de contact d’une agence. Chacun a été soumis à Jev le 21 septembre 2026 avec les questions exactes qu’utilise notre logiciel CRM Inklura pour qualifier les demandes. Les graphiques montrent les réponses brutes du modèle ; le panneau de droite applique la règle que notre code utilise en production.
Trois détails méritent l’attention. La refonte bien décrite coche presque toutes les cases, mais le service « nouveau projet » n’obtient que 85 % de probabilité, l’essentiel du reste allant à « aucun service » : sa confiance tombe à 0,77, sous notre seuil de 0,85, et le code propose l’orientation sans l’appliquer. Descendez le curseur à 0,77 et le message part tout seul au bon service. Le formulaire presque vide partage ses probabilités entre « autre » (60 %) et « prospect » (40 %), soit une confiance de 0,54 : c’est exactement ce qu’il faut en penser. Enfin, la candidature « nomme un besoin précis » à 93 %. C’est vrai, mais ce besoin n’est pas le nôtre. Une réponse isolée ne prouve rien ; c’est leur combinaison qui décide.
L’IA donne son avis, le code décide
Dans nos outils, Jev ne prend jamais une décision seul. Il fournit des mesures ; un code ordinaire, relu et testé, les transforme en action. Chaque avis suit le même trajet.
- Préparer le contexteLe code rassemble ce que la question exige : le message, les champs du formulaire, le nom du site et ses services. Rien de plus. Nous transmettons le domaine d’une adresse e-mail, jamais l’adresse, ni le statut déjà attribué à la demande : le modèle lit à l’aveugle.
- Poser toutes les questions d’un coupUne question d’ensemble (la note) et des questions précises (la nature du message, le besoin, le client déjà connu, le service concerné) partent dans le même appel.
- Composer en codeDes seuils écrits dans le programme, chacun accompagné de la mesure qui le justifie, transforment les réponses en décision : agir, proposer à une personne, ou ne rien proposer.
- Conserver l’avisL’avis est enregistré avec la version exacte du modèle et une empreinte du contenu jugé. Si le message ou les questions changent, l’avis ne compte plus : il n’est ni affiché, ni utilisé, et il sera refait.
Une règle d’asymétrie traverse tout le reste : l’accord entre des questions précises ne suffit jamais à lever une alerte de la question d’ensemble. Il peut la confirmer, pas l’effacer. Et certaines décisions ne sont jamais automatiques : aucune demande de contact n’est écartée sans une personne, parce que perdre un vrai client coûte bien plus cher que relire un démarchage.
Une IA qui ne rédige pas peut-elle halluciner ?
On parle d’hallucination quand une IA générative affirme avec aplomb un fait inventé : une source qui n’existe pas, un chiffre faux dans un texte parfaitement rédigé. Avec Jev, ce risque change de forme. Le modèle ne peut pas répondre en dehors des options qu’on lui propose, ni glisser une affirmation inventée dans une phrase, puisqu’il n’en écrit pas.
Il peut en revanche choisir la mauvaise option, parfois avec assurance. TypeSafe le rappelle lui-même : une réponse bien formée garantit le format, pas la vérité. La parade ne tient donc pas au modèle, mais à la façon de l’utiliser : des questions précises, des seuils mesurés, et une personne dans la boucle tant que les chiffres ne montrent pas le contraire.
Nos cas d’usage : e-commerce, support client, CRM et SEO
Nous avons d’abord intégré Jev au catalogue d’une boutique en ligne de pièces détachées que nous développons, puis repris la même méthode, avec le même code partagé, dans quatre autres outils. Tous interrogent la même version du modèle, figée pour que nos réglages restent valables.
| Outil | La question posée à Jev | Ce que l’automatisme ferait | Au 21 septembre 2026 |
|---|---|---|---|
| Catalogue d’une boutique de pièces détachées | Cette offre fournisseur désigne-t-elle la même pièce que notre fiche produit ? La pièce, la couleur et le conditionnement sont aussi lus de chaque côté. | Détacher une offre qui désigne une autre pièce. | Actif depuis le 19 septembre : 21 offres détachées, aucune annulée à ce jour. |
| Support client | Ce message est-il un envoi de masse, un démarchage ou une vraie demande ? | Classer le message en indésirable. | En attente. |
| CRM Inklura : demandes entrantes | La demande est-elle à traiter, et par quel service ? | Transmettre au bon interlocuteur, jamais écarter. | En attente. |
| Suivi SEO : mots-clés et concurrents | Ce mot-clé correspond-il au métier et à la zone du client ? Ce site est-il un concurrent ou un annuaire ? | Retirer un mot-clé du suivi, masquer un faux concurrent. | En attente (deux automatismes). |
| Suivi SEO : liens entrants | Ce lien pèse-t-il vraiment ? Ce site est-il une copie générée ? | Reclasser un lien, écarter un site du calcul. | En attente (deux automatismes). |
Aucun avis n’est demandé pendant l’affichage d’une page. Ils le sont à la fin d’une synchronisation avec un fournisseur, depuis un bouton dans l’outil ou par une tâche lancée à la demande. Vos visiteurs n’attendent donc jamais une IA : les pages lisent l’avis déjà enregistré, ou s’affichent sans.
Automatisation IA : à quelles conditions laisser l’IA agir seule ?
Chaque automatisme a deux étages. Le premier propose : il enregistre l’avis, l’affiche sur une fiche, trie une liste à relire. Il fonctionne dès le premier jour, et c’est là que se trouve l’essentiel du gain de temps. Le second agit sans intervention : il détache une offre, classe un message, transmet une demande. Ce second étage passe par ce que nous appelons une porte d’autonomie, qui ne s’ouvre que si cinq conditions sont réunies. Car une IA fiable n’est pas une IA qui ne se trompe jamais : c’est une IA dont on a mesuré les erreurs avant de lui confier quoi que ce soit.
- Un choix humain, enregistré avec le nom de la personne et la date.
- Une évaluation à jour : l’automatisme a été rejoué sur des décisions passées de vraies personnes, avec la version actuelle des questions et du modèle.
- Une mesure complète : une évaluation interrompue ne donne aucune permission. Cette condition a été ajoutée en généralisant la méthode ; l’évaluation du catalogue, la première, n’avait eu aucun appel en échec.
- Zéro élément gardé touché, sur un minimum fixé avant la mesure, et au moins une erreur réellement repérée : un automatisme qui ne fait rien ne touche rien non plus.
- Aucune annulation : une seule action annulée par une personne suffit à le remettre en simple proposition.
Modifier une question invalide d’un coup les avis enregistrés et l’évaluation : la porte se referme d’elle-même. Et chaque action automatique est signée, passe par le même code que le bouton utilisé par vos équipes et s’annule de la même façon.
Démo interactive : zéro erreur, mais sur combien d’exemples ?
Pourquoi exiger zéro erreur, et pourquoi sur autant d’exemples ? Parce que les deux erreurs n’ont pas le même prix. Une mauvaise association oubliée coûte une ligne de plus dans une liste à relire. Une bonne association retirée sans témoin, c’est un produit qui ne peut plus être commandé chez le bon fournisseur. À gauche, l’évaluation qui a ouvert le seul automatisme actif ; à droite, ce qu’un zéro permet réellement d’affirmer selon le nombre d’exemples.
La courbe suit la règle de trois des statisticiens : quand on n’observe aucune erreur sur n essais, le vrai taux d’erreur peut encore atteindre environ 3/n. Zéro erreur sur deux éléments ne dit presque rien (le taux peut monter jusqu’à 78 %) ; sur 686, il reste sous 0,5 %. Pour affirmer « moins de 1 % », il faut 299 éléments sans une seule erreur. C’est pourquoi nos minimums sont fixés avant l’évaluation, d’après le nombre d’exemples disponibles, et que nous ne les baissons jamais pour faire passer un automatisme.
Pourquoi six automatismes sur sept attendent encore
Aucun n’attend à cause d’un mauvais résultat : toutes les évaluations enregistrées affichent zéro élément gardé touché. Ils attendent parce que ce zéro porte sur trop peu d’exemples. Pour le suivi SEO, seuls 120 mots-clés gardés étaient concernés, pour un minimum de 300 ; côté concurrents, 33 sites seulement ont été choisis à la main ; pour les demandes entrantes, une seule décision humaine est enregistrée. Ces automatismes proposent déjà. Ils agiront quand nos équipes auront fourni assez d’exemples.
Une évaluation se fausse aussi facilement. Dans le support, les 34 messages qu’une personne avait classés indésirables l’avaient déjà été par nos filtres : mesurer l’IA sur ces exemples revient à vérifier qu’elle est d’accord avec un filtre qui fonctionne déjà. De même, relancer une mesure jusqu’à ce qu’elle passe revient à se noter soi-même. Nous avons croisé ces pièges pendant l’intégration, et la porte refuse désormais toute évaluation incomplète.
Nos garde-fous techniques
- Une version figée du modèle (
jev-1.13.0), jamais un alias qui peut changer sans prévenir : nos seuils ont été mesurés sur cette version. - Aucune IA sur le chemin de vos pages. Le 21 septembre au matin, pendant la rédaction de cet article, l’API de TypeSafe s’est déclarée surchargée plusieurs minutes. Nos pages n’en ont rien su : elles lisent des avis déjà enregistrés.
- Une clé qui reste sur le serveur, envoyée à une seule adresse vérifiée.
- Jamais d’avis inventé : en cas de panne, l’écran indique « avis non calculé » plutôt qu’une valeur par défaut.
Quelles tâches automatiser avec Jev ?
Jev est utile quand une application doit trancher vite entre des options connues, à partir de texte : trier des messages, orienter une demande vers la bonne personne, rapprocher deux fiches produits, vérifier qu’un contenu respecte une règle, classer des avis ou des tickets. Il l’est beaucoup moins pour rédiger, calculer, compter ou comparer des dates : un modèle génératif ou quelques lignes de code font mieux. Pour un assistant qui converse avec vos visiteurs, voyez plutôt notre article sur le chatbot : gadget ou atout commercial.
Le vrai point de départ d’un projet n’est d’ailleurs pas le modèle, mais les décisions dont vous disposez déjà. Un tri que votre équipe fait à la main depuis des mois est un excellent candidat : ses décisions passées permettent de mesurer l’IA avant de lui confier quoi que ce soit. C’est la démarche que nous suivons pour l’automatisation de processus par IA, pour nos applications métier sur mesure et pour faire passer un prototype d’IA en production. Pour un premier tour d’horizon, relisez ce que l’IA change concrètement pour les entreprises.
Questions fréquentes sur Jev et l’automatisation IA
Jev remplace-t-il ChatGPT ou Claude en entreprise ?
Non. Jev ne rédige rien. Il complète un modèle génératif quand il faut une décision rapide que le code peut vérifier, et laisse la rédaction ou le raisonnement long aux modèles faits pour cela.
Les données envoyées à Jev servent-elles à entraîner le modèle ?
Selon TypeSafe, Jev n’est pas entraîné sur les requêtes ni sur les réponses de ses clients. Nous limitons de toute façon ce qui part au strict nécessaire, par exemple le domaine d’une adresse e-mail plutôt que l’adresse complète.
Combien coûte une évaluation d’automatisme avec Jev ?
Celle du catalogue a porté sur 942 associations et environ 4 millions de jetons, soit autour de 0,17 $ au tarif affiché par TypeSafe. Le vrai coût est ailleurs : il faut des décisions passées, prises par des personnes, pour avoir quelque chose à mesurer.
Jev comprend-il les messages rédigés en français ?
Oui, mais TypeSafe indique que l’anglais reste sa langue la plus précise. Nos consignes sont rédigées en anglais, un glossaire traduit le vocabulaire métier français, et nos seuils ont été mesurés sur de vrais contenus en français.
Que se passe-t-il pour le site si le service de TypeSafe est indisponible ?
Rien de visible pour vos visiteurs : les pages lisent des avis déjà enregistrés. Les avis manquants sont simplement demandés au passage suivant, et l’outil indique ceux qui n’ont pas encore été calculés.
Peut-on ajouter Jev à un site WordPress existant ?
Oui, à condition que l’appel parte du serveur et jamais du navigateur, pour que la clé reste secrète. Le plus long n’est pas le branchement : c’est de définir les bonnes questions, puis de réunir les décisions qui serviront à mesurer le modèle.
Des demandes à trier, des décisions à automatiser ?
Depuis Brest, nous intégrons l’intelligence artificielle dans les sites et les outils métier de nos clients, partout en France. Regardons ensemble quelles décisions confier à un modèle, comment les mesurer, et à quelle condition le laisser agir seul.
Parlons de votre projetSources et méthode. Documentation TypeSafe consultée le 21 septembre 2026 : introduction, System One, types de questions, confiance, modèles et tarifs, limites de jev-1.13. Démonstrations : messages inventés, réponses réelles de jev-1.13.0 obtenues le 21 septembre 2026 avec nos questions de production. Chiffres d’évaluation : relevés dans nos outils les 19 et 20 septembre 2026, relus le 21. Les clients concernés ne sont pas nommés.
Ces articles peuvent vous intéresser

Peut-on faire confiance à l'IA pour écrire le contenu de son site ?
L'IA peut rédiger des textes en quelques secondes. Mais faut-il lui confier le contenu de votre site ? Notre réponse nuancée et honnête.
Lire
Un chatbot sur votre site : gadget ou vrai atout commercial ?
Les chatbots se sont beaucoup améliorés grâce à l'IA. Voici dans quels cas c'est un vrai plus pour votre entreprise, et quand ça ne sert à rien.
Lire
L'intelligence artificielle pour les entreprises : qu'est-ce que ça change concrètement ?
L'IA fait beaucoup parler, mais qu'est-ce que ça change vraiment pour une PME ? On démystifie le sujet avec des exemples concrets et accessibles.
LireCe que nous proposons
Intéressé par nos services web ?
Découvrez comment nous pouvons vous aider à développer votre présence digitale et atteindre vos objectifs en ligne.